TL;DR
Kafka 설계문서를 읽다가 모든 메시지를 디스크에 쓴다면서 빠르다고 해서 그게 말이 되나 싶었다. 파고들어 보니 데이터를 안 잃는 방법을 fsync가 아니라 replication으로 바꿔놨고, 그 선택이 캐시를 OS에 맡기는 것으로, 다시 zero-copy로, 로그를 언제 어떻게 지우는지까지 이어지고 있었다.
다 디스크에 쓰는데 빠르다고?
Kafka 설계문서를 읽다가 한참 멈춰 있었던 문단이 있다. 모든 메시지를 파일 끝에 붙이기만 하고 중간을 고치거나 지우지 않는다는 대목이었다.
순차 쓰기가 빠르다는 것 자체는 납득이 됐다. 문서에 인용된 수치로 순차가 600MB/s인데 랜덤은 100KB/s라고 하니 차이가 크긴 하다.
그래도 이상했다. 디스크는 디스크인데, 메모리에 들고 있는 큐보다 빠를 수는 없을 것 같았다. 게다가 붙이기만 하면 파일이 계속 커질 텐데 Kafka는 보통 트래픽이 많은 자리에 놓이니까, 하루에 수 TB씩 들어오는 곳이면 일주일도 안 돼서 디스크가 남아나지 않을 것 같았다.
궁금한 게 한꺼번에 몰려왔다.
- 디스크에 다 쓰면서 어떻게 빠르지?
- 이 파일들은 언제 지워지는 거지?
- 컨슈머가 아직 안 읽은 데이터도 지우나?
- 지운다면 파일 중간의 오래된 메시지만 골라 지우나?
안 잃겠다면서 fsync를 안 한다
디스크에 다 쓰면서 어떻게 빠른지부터 파봤다. 그러다 예상 못 한 걸 봤다. Kafka는 메시지를 받아서 write() 하고 끝낸다. fsync를 안 부른다.
log.flush.interval.messages 기본값이 사실상 무한대라, 언제 디스크에 내릴지를 OS에 완전히 맡긴다는 뜻이다. 그런데 커널이 아직 디스크로 안 내린 데이터는 전원이 나가면 사라진다. 메시지를 안 잃겠다는 시스템이 디스크에 썼는지 확인을 안 하는 셈이다.
설계문서에 선택지가 둘로 정리되어 있었다. 디스크에 확실히 쓰거나, 여러 대에 복사하거나다. Kafka는 후자를 골랐다.
브로커 한 대가 전원이 나가서 메모리에 있던 걸 통째로 잃어도 같은 데이터가 다른 브로커에 있다. acks=all이면 ISR에 속한 브로커들이 다 받았을 때만 프로듀서에게 ack를 준다. 내구성의 기준을 디스크에서 머신 대수로 옮긴 것이다.
캐시도 자기가 안 들고 있다
그리고 하나 더 있었다. JVM 애플리케이션이면 보통 heap에 캐시를 들고 있는데 Kafka는 일부러 안 그런다. OS의 page cache에 맡긴다.
이유가 문서에 있다. 자바 객체로 들고 있으면 실제 데이터보다 메모리를 훨씬 많이 먹고 heap이 커질수록 GC가 무거워진다. 파일을 읽으면 어차피 OS가 page cache에 올리니까 heap에도 캐싱하면 같은 데이터가 두 벌이 된다. 그리고 프로세스 안에 들고 있으면 재시작할 때마다 캐시가 비는데 page cache는 커널이 갖고 있어서 그대로 남아 있다.
여기가 두 선택이 교차하는 지점이었다. fsync를 안 해도 되니까 page cache를 믿고 쓸 수 있고, page cache에 데이터가 있으니까 전송도 커널에 맡길 수 있다.
브로커가 컨슈머에게 메시지를 보낼 때 파일을 읽어서 소켓에 쓰지 않는다. sendfile이라는 syscall로 커널에 통째로 맡기면 디스크에서 랜카드까지 데이터가 브로커의 메모리를 한 번도 거치지 않고 간다. 이걸 zero-copy라고 부른다.
만약 Kafka가 데이터를 heap에 캐싱했다면 그건 유저 공간 메모리라 커널이 모르는 곳이고, sendfile을 부를 수가 없다. 캐시를 커널에 맡긴 결정이 전송 방식까지 정한 것이다.
언제, 어떻게 지우나
이제 두 번째 질문이다. 이렇게 쌓인 파일들은 언제 지워질까. 답은 허무할 만큼 단순했다. 일정 시간이 지나면 지운다.
설정이 두 개 있는데 log.retention.hours가 기본 168, 그러니까 7일이고, log.retention.bytes는 파티션마다 크기 상한을 거는 값인데 기본은 무제한이다. 둘 중 먼저 걸리는 쪽이 적용된다.
그런데 이 기준을 보다가 이상한 걸 발견했다. 어디에도 컨슈머가 없다. 아무도 안 읽은 메시지여도 7일이 지나면 사라진다는 뜻이고, 컨슈머가 주말 내내 죽어 있었으면 그 사이 데이터는 그냥 놓치게 된다.
브로커가 컨슈머를 안 보는 게 이상했는데, RabbitMQ 같은 전통적인 큐와 비교해보니 이유가 보였다. 그쪽은 컨슈머가 가져가면 그때 지운다. 그러려면 브로커가 누가 무엇을 가져갔는지 계속 추적해야 하고 컨슈머마다 다른 상태를 들고 있어야 한다.
Kafka는 그 추적을 아예 안 한다. 어디까지 읽었는지는 컨슈머가 자기 offset으로 들고 있고 브로커는 시간만 본다. 컨슈머별로 다른 처리를 안 하니까 같은 파일 구간을 그대로 여러 명에게 흘려보낼 수 있다. 이것도 zero-copy가 가능한 조건 중 하나다.
파일 중간을 파내지 않는다
지우는 방식을 보다가 또 놀랐다. 파티션 하나가 거대한 파일 하나인 줄 알았는데 아니었고, 세그먼트라는 단위로 잘게 쪼개져 있었다.
/var/kafka-logs/orders-0/
  00000000000000000000.log
  00000000000000368920.log
  00000000000000742301.log
파일 이름의 숫자가 그 파일에 담긴 첫 메시지의 offset이다. 기본값으로 1GB가 차면 새 파일로 넘어가고, 크기가 안 차더라도 설정된 시간이 지나면 넘어간다고 한다.
그리고 삭제는 이 파일 단위로 일어난다. 오래된 세그먼트를 통째로 지운다.
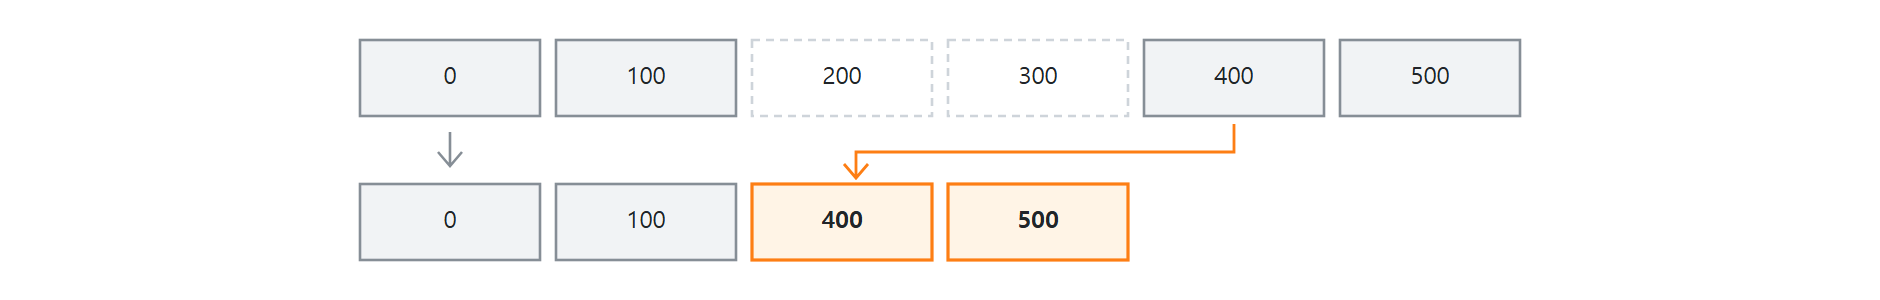
파일 중간의 메시지만 지우면 위치가 밀린다
세그먼트 파일을 통째로 버리면 위치가 그대로다
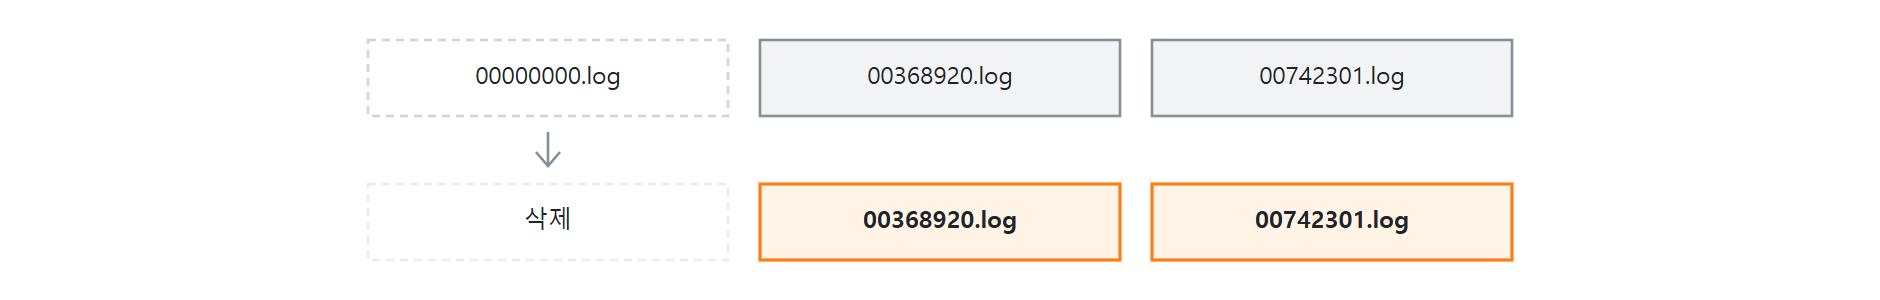
여기서 한 번 더 고민거리가 생겼다. 공간만 놓고 보면 중간의 오래된 메시지만 골라 지우는 게 더 촘촘할 텐데 굳이 파일 단위로 버리는 이유가 뭘까. 앞에서 본 sendfile이 답이었다.
zero-copy가 성립하려면 조건이 하나 붙는다. 브로커가 파일 내용을 건드리지 않아야 한다. 파일 중간을 파내면 뒤에 있던 데이터의 위치가 전부 밀리니까 offset과 파일 위치의 대응을 다시 계산해야 하고, 그러려면 브로커가 파일을 열어서 손봐야 한다.
파일을 통째로 버리면 남은 파일들은 손도 대지 않은 상태 그대로라서 삭제를 해도 zero-copy가 유지된다. 지우는 방식까지 성능 설계가 정한 것이었다.
지우면 안 되는 데이터는
사용자 프로필이나 상품 가격처럼 최신 상태가 계속 필요한 데이터는 7일 지났다고 없어지면 곤란하다.
이런 토픽을 위해 cleanup.policy=compact가 따로 있는데, 시간이 아니라 키 기준으로 정리한다. 같은 키로 열 번 썼으면 마지막 값만 남기고 앞의 아홉 개를 지우는 식이라, 로그가 아무리 길어도 최종 크기는 키 개수에 비례하게 된다. 값을 null로 쓰면 그 키를 지우라는 표시가 된다고 한다.
Kafka 자기 내부 토픽인 __consumer_offsets가 이 방식을 쓴다. 컨슈머 그룹별로 지금 offset만 있으면 되니까 과거 기록이 필요 없기 때문이다.
용량 자체를 줄이는 쪽
압축도 있는데 여기서도 같은 원칙이 또 나온다. 프로듀서가 배치를 압축해서 보내면 브로커는 압축된 상태 그대로 저장하고 컨슈머에게도 압축된 채로 보낸다. 푸는 건 컨슈머가 한다.
브로커가 풀었다가 다시 압축하면 그 순간 바이트를 건드리는 거라 zero-copy가 깨지기 때문인데, 그래서 기본 설정이 compression.type=producer, 프로듀서가 한 것을 그대로 두라는 뜻이다. zstd를 쓰면 텍스트 계열은 3배에서 5배까지 줄어든다.
여기서 이름 때문에 한 번 걸렸다. 공식 문서에는 앞에서 본 cleanup.policy=compact가 Log Compaction, 우리말로 "로그 압축"이라고 나온다. 이름은 압축인데 데이터를 작게 만드는 게 아니라 오래된 키 값을 버리는 것이라, 지금 얘기하는 compression과는 전혀 다른 기능이다.
| 로그 압축 (compaction) | 압축 (compression) | |
| 설정 | cleanup.policy=compact |
compression.type |
| 하는 일 | 오래된 키 값을 버린다 | 같은 데이터를 작게 만든다 |
| 데이터 손실 | 있다 (과거 값) | 없다 |
| 기준 | 키 | 바이트 |
용량은 이렇게 계산하고, 넘치면 S3로 뺀다
클러스터 용량을 잡을 때 쓰는 식은 간단하다.
필요 용량 = 초당 유입량 × 보존 기간 × replication factor초당 100MB가 들어오고 7일 보존에 replication factor가 3이라면
100MB/s × 604,800초 × 3 = 약 181TB압축으로 3배 줄이면 60TB쯤 된다. 처음 계산해보고 놀랐던 건 replication factor가 그대로 곱해진다는 점이었다. 안 잃으려고 3벌을 두면 용량도 정직하게 3배가 된다.
최근에 한 칸이 더 생겼는데 Tiered Storage라고 하고, Kafka 3.6에서 실험적으로 나와서 3.9부터 제대로 쓸 수 있다고 한다.
오래된 세그먼트를 S3 같은 오브젝트 스토리지로 내보내고 브로커 로컬 디스크에는 최근 것만 두는 방식이라, 보존 기간을 몇 달로 늘려도 브로커 디스크가 버티고 비싼 로컬 SSD 대신 싼 스토리지를 쓰니 비용도 준다.
다만 원격에 있는 세그먼트를 읽을 때는 zero-copy를 쓰지 못한다. S3에서 받아와야 하니까 브로커의 유저 공간을 거칠 수밖에 없다.
영속성을 택한 뒤로 전부 따라왔다
처음 궁금했던 건 디스크에 다 쓰면서 어떻게 빠르냐는 거였는데, 파고들어 보니 순서가 거꾸로였다. 빠르게 만들려고 이것저것 최적화한 게 아니라, 안 잃는 방법을 replication으로 정한 순간 나머지가 줄줄이 따라온 것이었다.
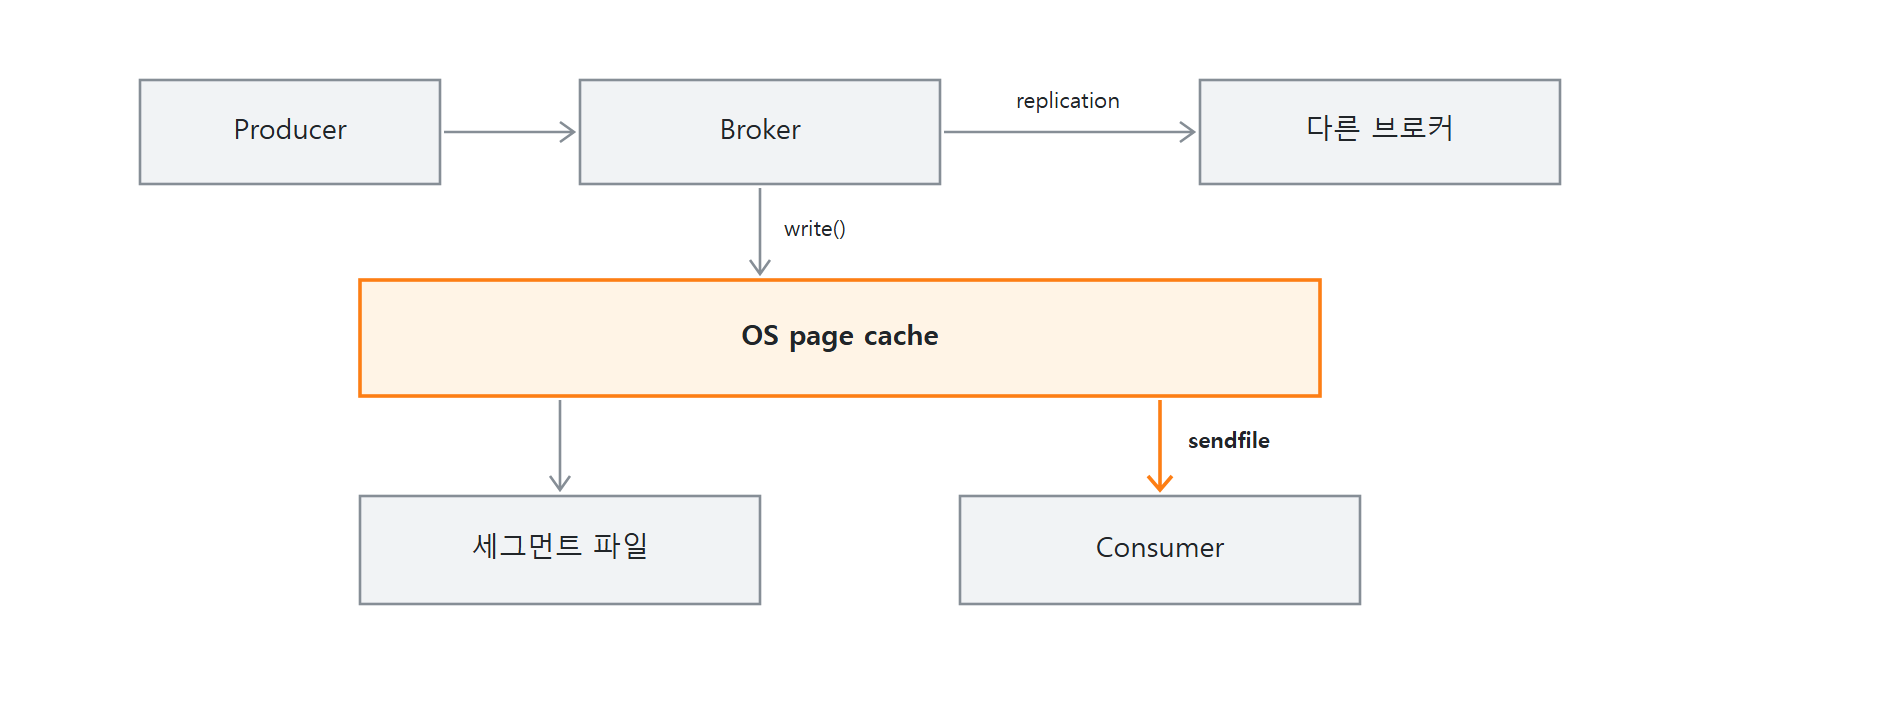
용량 관리 정책이라고 생각했던 것들이 사실은 윗단 결정을 지키기 위한 조건이었다. 세그먼트를 통째로 지우는 것도, 브로커가 재압축하지 않는 것도, 컨슈머 상태를 추적하지 않는 것도 전부 브로커가 바이트를 건드리지 않게 하려는 선택이다.
그러고 나니 zero-copy가 꺼진다는 경우들도 한 줄로 설명이 됐다. SSL을 켜면 암호화하려고 건드려야 하고, 구버전 컨슈머가 붙으면 포맷을 바꾸려고 건드려야 하고, 원격 세그먼트를 읽으면 가져오려고 건드려야 한다. 증상은 다 다른데 원인은 전부 같다.
설계문서를 읽을 때 각 항목을 따로따로 외우려고 했는데, 그렇게 보면 계속 안 외워지는 게 당연했다. 하나의 결정에서 나온 결과들이라 그 결정을 먼저 잡으면 나머지는 저절로 따라온다는 걸 이번에 알았다.
Kafka를 쓰면서 설정값만 보고 넘겼던 것들이 왜 그 기본값인지 이제야 이해가 된다. 다음에 SSL을 켜거나 보존 기간을 늘릴 일이 생기면 무엇을 포기하는 건지 알고 결정할 수 있을 것 같다.
그런데 정리하고 나서 찾아보니 윗단 결정 자체를 바꾸려는 논의가 이미 진행 중이었다. 내구성을 브로커끼리의 replication이 아니라 S3 같은 오브젝트 스토리지에 맡기면 어떻게 되느냐는 건데, KIP-1150이라는 이름으로 올라와 있고 제안 자체는 채택됐지만 구현을 정하는 KIP는 아직 논의 중이라고 한다.
윗단이 바뀌면 아래가 전부 흔들린다. 브로커가 데이터를 소유하지 않으면 page cache도, sendfile도, 세그먼트를 통째로 지우는 것도 전제가 사라진다. 그때 Kafka는 무엇으로 남는지가 궁금해져서 다음 글에서 이어 보려고 한다.