TL;DR
앞 글에서 컨테이너가 리눅스 커널 기능이라는 걸 정리하고 나니 의문이 남았다. 커널이 다 하는 거면 도커는 뭘 만든 건가. 찾아보니 커널 코드는 한 줄도 안 썼고 초기 버전은 LXC를 호출하기만 했다. 컨테이너 기능은 VPS 호스팅 업체들이 10년에 걸쳐 커널에 밀어 넣은 것이었고, 그렇게 밀어 넣을 수밖에 없게 만드는 규칙이 리눅스 안에 있었다.
커널이 다 하는 거면 도커는 뭘 했나
앞 글에서 컨테이너가 호스트 커널을 공유한다는 걸 정리했다. 격리는 namespace가 하고 자원 제한은 cgroup이 한다. 둘 다 리눅스 커널 기능이다.
정리하고 나니까 좀 이상했다. 격리도 커널이 하고 자원 제한도 커널이 하는데, 그럼 도커가 만든 건 뭔가 싶었다.
namespace는 도커보다 10년 빠르다
들어온 순서를 찾아보니 이랬다.
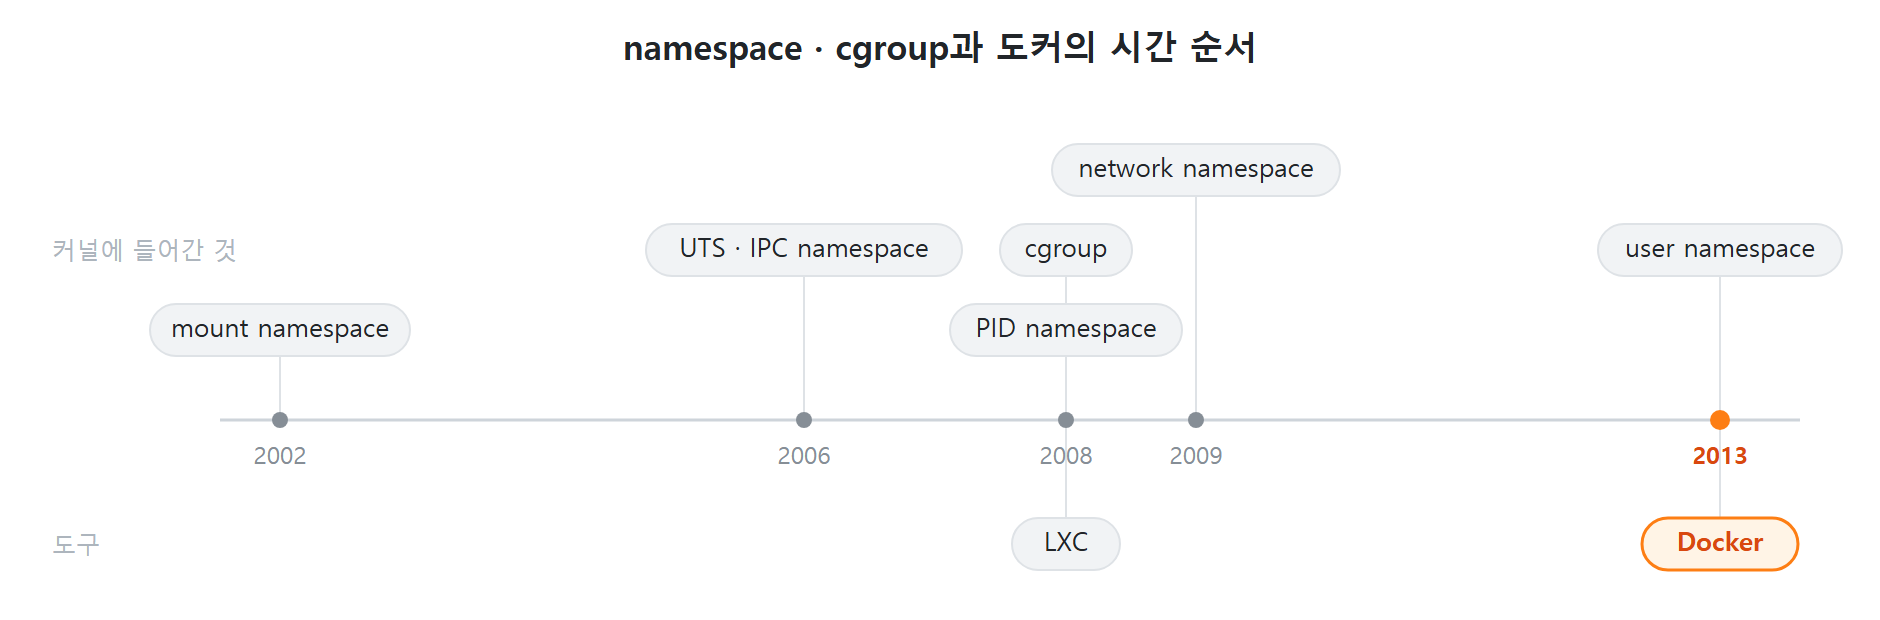
도커가 나온 2013년에는 필요한 게 거의 다 들어와 있었다. 그걸 묶어 쓰는 도구인 LXC도 5년 먼저 나와 있었고, 초기 도커는 그 LXC를 호출하는 래퍼였다.
그럼 이것들은 누가 만들어서 커널에 넣은 건가. cgroup은 구글이 만들었다. 서버 한 대에 job을 여러 개 올려야 하는데 하나가 메모리를 다 먹으면 옆 job이 죽으니까, 누가 얼마나 쓰는지 세고 넘으면 막는 기능이 필요했다. 처음 이름은 process containers였는데 container라는 말이 이미 여러 뜻으로 쓰여서 control groups로 바꿨다. namespace 쪽은 출신이 좀 다르다.
커널 패치로 컨테이너를 팔던 시절
2000년대 초에 이미 컨테이너를 파는 회사가 있었다. OpenVZ와 Linux-VServer다. 아래는 OpenVZ를 기준으로 본다.
고객은 웹호스팅 업체였다. 이들이 팔던 게 VPS인데, 서버 한 대를 가상으로 나눠 "나만의 서버"처럼 주는 상품이다. 지금의 EC2 인스턴스와 같은 개념이라고 보면 된다. 한 대를 100명에게 나눠 팔아야 마진이 나오는데, VM으로 띄우면 게스트마다 커널이 메모리를 먹어서 열몇 개만 올려도 램이 찬다. 커널은 하나만 쓰고 위층만 나누는 방식이 필요했고 그게 OpenVZ였다.
문제는 이 기능이 리눅스 커널에 없었다는 거다. 그래서 이들은 커널 소스에 패치를 수십만 줄 얹어 직접 컴파일한 커널을 배포했다. 도입하는 쪽은 CentOS를 깔고, CentOS 기본 커널을 버리고, OpenVZ가 만든 커널로 부팅했다.
out-of-tree가 왜 힘든가
이렇게 커널 저장소 밖에서 따로 유지하는 코드를 out-of-tree라고 한다. 리눅스 커널 소스는 git 저장소 하나인데 이걸 mainline이라고 부르고, 거기 들어간 코드는 in-tree다.
커널은 out-of-tree가 유독 힘든데 규칙 때문이다. 리눅스는 커널 내부 API의 안정성을 보장하지 않는다. 함수 시그니처든 자료구조든 필요하면 갈아엎는다. 커널 문서에 stable-api-nonsense라는 이름의 문서가 따로 있을 만큼 의도적이다.
메인테이너가 구조체를 바꾸면 in-tree 코드는 그 사람이 영향받는 곳까지 같이 고쳐서 커밋한다. out-of-tree는 아무도 모르니까 다음 커널 버전에서 빌드가 깨지고 알아서 고쳐야 한다. 커널은 9주에서 10주마다 새 버전이 나오니 리베이스가 끝나지 않는다.
쓰는 쪽에서는 커널 보안 패치가 나와도 바로 못 올렸다. OpenVZ 팀이 새 버전에 패치를 다시 얹어 내줄 때까지 몇 주에서 몇 달을 기다려야 했다. 기능을 얻는 대신 커널을 언제 올릴지를 남이 정하게 된 셈이다.
그래서 mainline에 밀어 넣었다
OpenVZ가 택한 방법이 기능을 잘게 쪼개서 mainline에 하나씩 넣는 거였다. 한 번 들어가면 내부 API가 바뀌어도 바꾼 사람이 같이 고쳐주고, 모든 배포판에 자동으로 따라 들어간다.
대신 자기 설계를 포기해야 했다. 메인테이너들이 특정 제품 전용 구조를 안 받아주니 범용으로 다시 깎아야 했다. 그래서 커널에 들어간 PID namespace는 OpenVZ가 원래 쓰던 것과 다르다. 더 작고 일반적이다. user namespace는 보안 문제로 통과까지 6년이 걸렸다.
syscall은 안 건드리고 내부 함수는 마음대로 바꾼다
앞에서 커널 내부 API는 안정성을 보장하지 않는다고 했다. 그런데 syscall처럼 밖으로 노출된 인터페이스는 반대로 절대 건드리지 않는다.
| 경계 | 규칙 | 고생하는 쪽 |
| 바깥 (syscall, /proc) | 절대 안 깨뜨린다 | 커널 개발자가 쓰레기를 영원히 관리 |
| 안쪽 (커널 내부 함수) | 마음대로 깨뜨린다 | out-of-tree 유지하는 쪽이 매번 리베이스 |
syscall이나 /proc 같은 인터페이스를 안 바꾼 덕에 2005년에 컴파일한 바이너리가 지금 커널에서 돈다. 그래서 보안 패치가 나오면 검증 없이 올릴 수 있고, 배포판이 10년짜리 지원을 팔 수 있다.
대신 잘못 만든 인터페이스도 못 지운다. 파일 정보 읽는 syscall만 해도 stat, stat64, newfstatat, statx로 네 벌이 쌓여 있다. 추가는 되는데 삭제가 안 되니 계속 늘어난다.
커널 내부에는 그런 제약이 없다. 개발자가 필요하면 자유롭게 갈아엎을 수 있고, 덕분에 오래된 구조가 계속 정리된다. 대신 그때마다 out-of-tree 코드가 깨진다.
두 규칙을 같이 놓고 보면 결론이 하나다. 커널 밖에서 유지하면 새 버전마다 깨지고, mainline에 들어가면 남이 고쳐준다. OpenVZ가 10년 만에 mainline으로 들어간 이유다.
다시 도커로
그래서 도커가 나올 무렵에는 커널 쪽에 남은 일이 없었다. 도커가 만든 건 그 위였다.
- 이미지 레이어와 포맷
- Dockerfile로 환경을 텍스트에 적는 방식
- registry, 남의 이미지를 받아 쓰는 통로
- 설정 파일 대신
docker run한 줄
LXC는 같은 커널 기능을 쓰면서도 설정 파일을 직접 쓰게 했다. 도커는 그걸 명령 하나로 줄였다.
앞 글에서도 비슷한 결론이었다. dockur/windows가 판 것도 20년 된 기술을 명령 한 줄로 줄인 설치 과정이었다. 두 번 연속으로, 내가 대단하다고 생각했던 자리에 있던 건 남이 만들어둔 걸 쓰기 쉽게 묶은 결과였다.
'DevOps & Infra > Docker' 카테고리의 다른 글
| [Docker] 윈도우에서 돌리면 윈도우 컨테이너가 되는 거 아닌가요? (0) | 2026.09.28 |
|---|---|
| [Docker] 컨테이너 통신: Bridge부터 User-defined까지 (0) | 2025.11.28 |